Cyber-Risiko quantifizieren: was sich zählen lässt — und was nur modelliert werden kann
Cyber-Risiko quantifizieren: wie die Rechnung funktioniert, warum gezählte und modellierte Werte getrennt bleiben und woran eine belastbare Zahl erkennbar ist.
- Die Cyberrisiko-Quantifizierung ersetzt die Heatmap nicht durch Gewissheit, sondern durch eine Rechnung: wie oft ein Ereignis eintritt, mal was es kostet — beides als Spanne, nicht als Punktwert.
- Die entscheidende Trennlinie verläuft zwischen gezählten und modellierten Werten. Wer beides zu einer Zahl addiert, kann bei der ersten Rückfrage nicht mehr sagen, welcher Teil belastbar war.
- Branchendurchschnitte beschreiben andere Unternehmen. Für die eigene Entscheidung zählen die eigenen Ausgaben, die eigenen dokumentierten Vorfälle — und die Annahmen, die daneben stehen.
Inhalt
- Was Cyberrisiko-Quantifizierung von einer Risikobewertung unterscheidet
- Abgrenzung: Nachweis ist nicht Priorisierung
- Zwei Größen — und die Unsicherheit, die in beiden steckt
- Die eigentliche Trennlinie: gezählt oder modelliert
- Warum Branchendurchschnitte die eigene Zahl nicht ersetzen
- Wie die Rückfrage verläuft
- Drei Fragen, die eine Zahl aushalten muss
- Der stärkste Einwand dagegen
- Was Sie brauchen, um Ihr Cyber-Risiko zu quantifizieren
- Umsetzung im Financials-Modul von Mahoney Control
- Zurück an den Tisch
- Häufige Fragen zur Cyberrisiko-Quantifizierung
- Woran erkenne ich, ob eine Risikozahl belastbar ist?
- Was bedeutet es, dass ein Wert modelliert ist?
- Welche Daten brauche ich, um mit der Cyberrisiko-Quantifizierung zu beginnen?
- Wie oft sollte die Cyberrisiko-Quantifizierung wiederholt werden?
„Und was kostet uns das jetzt?“
Die Frage kommt selten am Anfang einer Sicherheitspräsentation. Gestellt wird sie am Ende, meist von der kaufmännischen Seite des Tisches, nachdem zwanzig Minuten lang über Schwachstellen, Rahmenwerke und Reifegrade gesprochen wurde. Und die Frage ist berechtigt: Wer über ein Budget entscheidet, muss eine Größenordnung nennen können — gegenüber der Geschäftsführung, gegenüber dem Aufsichtsgremium, gegenüber dem Controlling.
Die übliche Antwort ist eine Heatmap. Rot, gelb, grün; Eintrittswahrscheinlichkeit auf der einen Achse, Schadenshöhe auf der anderen. Die Heatmap ordnet Risiken zueinander, aber sie beantwortet die Frage nicht. Zwei rote Felder sagen nichts darüber, welches der beiden Risiken zuerst Geld bekommen sollte.
Genau diese Lücke schließt, wer sein Cyber-Risiko quantifiziert — international meist als Cyber Risk Quantification oder kurz CRQ bezeichnet. Die Quantifizierung übersetzt Risiko in dieselbe Größe, in der auch alle anderen unternehmerischen Entscheidungen bewertet werden: in Geld.
Dieser Beitrag beschreibt, wie diese Übersetzung funktioniert, wo ihre Grenzen liegen und woran sich eine belastbare Zahl von einer wohlklingenden unterscheiden lässt. Die These vorweg: Der Wert einer quantifizierten Risikozahl liegt nicht in ihrer Genauigkeit, sondern darin, dass sich ihre Herkunft zeigen lässt. Eine Zahl, deren Annahmen offenliegen, hält einer kritischen Rückfrage stand. Eine Zahl ohne sichtbare Annahmen fällt bei der ersten Rückfrage in sich zusammen — und mit der Zahl die Glaubwürdigkeit dessen, der sie vorgetragen hat.
Was Cyberrisiko-Quantifizierung von einer Risikobewertung unterscheidet
Eine qualitative Risikobewertung ordnet ein: hoch, mittel, niedrig. Diese Einordnung ist schnell, konsensfähig und in praktisch jedem Managementsystem für Informationssicherheit vorgesehen. Die Schwäche dieser Einordnung zeigt sich erst beim Vergleich. Ein „hoch“, das eine Fachabteilung auf ihrer Skala vergeben hat, ist nicht dasselbe „hoch“ wie das einer anderen Abteilung, und beide Bewertungen lassen sich nicht addieren.
Eine quantitative Analyse arbeitet stattdessen mit zwei Rechengrößen: wie häufig ein Ereignis in einem Zeitraum zu erwarten ist, und welche finanziellen Auswirkungen es hat, wenn es eintritt. Das Produkt aus beidem ergibt den jährlich erwarteten Verlust, im Fachjargon Annual Loss Expectancy. Dieser Verlustwert ist vergleichbar — zwischen Risiken und zwischen Standorten. Für die Investitionsentscheidung zählt allerdings nicht der Verlustwert selbst, sondern der Betrag, um den eine Maßnahme ihn senkt: Verglichen wird die Risikominderung mit den Kosten der Maßnahme, nicht der Gesamtwert mit dem Preis.
Ein Hinweis zur Aussagekraft: Der erwartete Verlust ist ein Mittelwert. Er beschreibt das, was über viele Jahre im Durchschnitt anfällt — nicht das, was ein einzelner schwerer Vorfall kostet. Für seltene Großschäden ist deshalb zusätzlich der obere Rand der Bandbreite interessant, nicht nur die Mitte.
Der Unterschied ist also nicht Präzision gegen Ungenauigkeit. Er ist Vergleichbarkeit gegen bloße Einordnung. Eine Heatmap sagt, dass ein Risiko wichtig ist. Eine Quantifizierung sagt, wie viel es wert wäre, an diesem Risiko etwas zu ändern. Vergleichbar sind zwei Beträge allerdings schon deshalb, weil sie Beträge sind — ob man dem Vergleich auch trauen kann, entscheidet die Herkunft. Und darauf kommt es an, sobald jemand widerspricht.
Abgrenzung: Nachweis ist nicht Priorisierung
Risiko taucht in zwei Zusammenhängen auf, die leicht verwechselt werden.
Im regulatorischen Zusammenhang geht es um Nachweis: dass ein Risikomanagement existiert, dass Maßnahmen umgesetzt und überwacht werden, dass sich das belegen lässt. Maßstab ist dort die Belegbarkeit, nicht die Höhe eines Betrags. Wie diese Nachweispflicht funktioniert, behandelt der Beitrag zur NIS2-Dokumentation.
Im kaufmännischen Zusammenhang geht es um Priorisierung: welche Maßnahme das meiste Risiko je eingesetztem Euro senkt. Maßstab ist die Vergleichbarkeit der Beträge. Genau dafür ist die Cyberrisiko-Quantifizierung gebaut — sie ordnet Investitionen nach ihrer finanziellen Wirkung, nicht nach der gefühlten Dringlichkeit einer Schwachstelle.
Beides gehört zusammen, ist aber nicht dasselbe. Eine lückenlos dokumentierte Organisation kann Geld an der falschen Stelle ausgeben, und eine gut gerechnete Priorisierung ersetzt keinen Nachweis. Dieser Beitrag behandelt die kaufmännische Seite.
Zwei Größen — und die Unsicherheit, die in beiden steckt
Häufigkeit. Wie oft ist mit einem Ereignis dieser Art zu rechnen? Für manche Ereignisklassen liegt die Antwort in den eigenen Systemen — blockierte Zugriffsversuche, ausgelöste Alarme, tatsächlich eingetretene Vorfälle. Für seltene, schwere Ereignisse gibt es solche Erfahrungswerte im eigenen Haus naturgemäß nicht.
Auswirkung. Was kostet ein Ereignis, wenn es eintritt? Hier stecken mehr Posten als die offensichtlichen: Wiederherstellung, Ausfallzeit, externe Unterstützung, Vertragsstrafen, Meldeaufwand, Nacharbeit im Betrieb. Der Aufwand liegt weniger im Rechnen als im vollständigen Erfassen.
Häufigkeit und Auswirkung sind keine festen Werte, sondern Verteilungen: Größen, die in einer Spanne schwanken, statt auf einem Punkt zu liegen. Deshalb arbeiten quantitative Verfahren mit einer Bandbreite und einem Konfidenzband — der Angabe, in welchem Bereich der Wert mit welcher Sicherheit liegt — statt mit einer einzigen Zahl.
Ein weit verbreitetes offenes Verfahren dieser Art ist FAIR (Factor Analysis of Information Risk). Es trennt die Häufigkeit von Verlustereignissen von der Höhe des Verlusts und gliedert beides weiter auf. Gerechnet wird mit Wertebereichen, nicht mit Punktwerten. FAIR ist eine Analyse-Methodik — kein Rahmenwerk, gegen das ein Unternehmen zertifiziert würde, und keine Zusicherung, dass die errechneten Werte eintreten. Die Ergebnisse sind orientierend.
Die eigentliche Trennlinie: gezählt oder modelliert
Hier liegt der Punkt, an dem die Cyberrisiko-Quantifizierung in der Praxis scheitert, und er hat nichts mit Rechenkunst zu tun.
Manche Werte lassen sich zählen. Was ein tatsächlich eingetretener Vorfall an Aufwand verursacht hat, was die eingesetzten Sicherheitswerkzeuge pro Gerät kosten, wie hoch die Ausgaben je Nutzer sind: Das steht in Tickets, Verträgen und Rechnungen. Diese Werte sind prüfbar. Das Controlling kann jede Zeile nachvollziehen. Ganz frei von Schätzung sind auch sie nicht — erfasste Bearbeitungszeiten und Kostenumlagen enthalten regelmäßig eine Annahme. Der Unterschied ist, dass sich diese Annahme an einem Beleg festmachen lässt.
Andere Werte lassen sich nur modellieren. Was ein Ereignis kosten würde, das im eigenen Haus noch nie eingetreten ist, ergibt sich nicht aus Daten, sondern aus Annahmen über Häufigkeit, Ausbreitung und Dauer. Das ist kein Mangel des Verfahrens, sondern die Natur der Sache. Über seltene Ereignisse gibt es keine eigene Statistik.
| Merkmal | Gezählt | Modelliert |
|---|---|---|
| Herkunft | Verträge, Rechnungen, Tickets | Annahme über ein Ereignis, das noch nicht eintrat |
| Prüfbarkeit | jede Position bis zur Quellzeile | prüfbar ist die Annahme, nicht der Betrag |
| Änderung durch | Korrektur in der Quelle | eine andere Annahme |
| Auf der Folie | Betrag mit Quellenangabe | Bandbreite mit Konfidenzband, als modelliert gekennzeichnet |
| Typischer Fehler | veraltete Ausgabenbasis | wird wie ein gezählter Wert präsentiert |
Das Problem entsteht erst, wenn beides zu einer Zahl addiert wird. Auf der Folie steht dann ein Euro-Betrag, dem nicht mehr anzusehen ist, welcher Teil aus dem Hauptbuch stammt und welcher aus einer Annahme. Fragt jemand nach, lässt sich die Zahl nicht mehr auseinandernehmen. Und die Rückfrage kommt — spätestens dann, wenn die Zahl eine unbequeme Investition begründen soll.
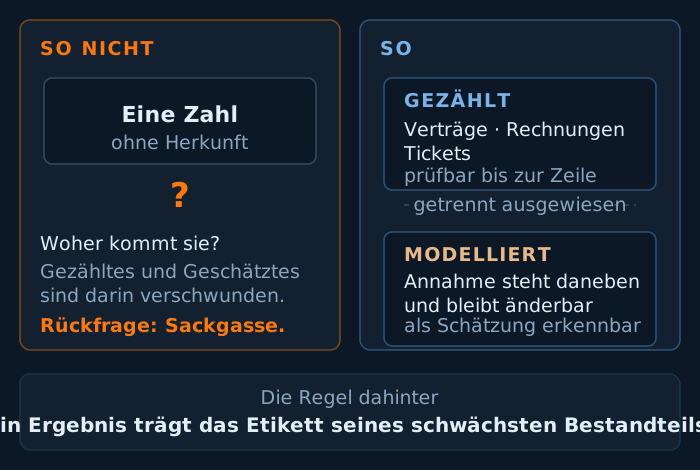
Damit kein Missverständnis entsteht: Die Regel lautet nicht, dass nie gerechnet werden dürfte. Der jährlich erwartete Verlust — das Produkt aus Häufigkeit und Auswirkung — enthält selbst zwei Größen, von denen mindestens eine fast immer geschätzt ist. Die Regel lautet: Ein Ergebnis trägt das Etikett seines schwächsten Bestandteils. Geht eine geschätzte Häufigkeit in die Rechnung ein, ist das Ergebnis ein modellierter Wert — auch dann, wenn die Auswirkung gezählt wurde. Falsch wird es erst, wenn ein solches Ergebnis mit tatsächlich angefallenen Kosten in einer Summe verschwindet und die Summe wie ein Kontostand präsentiert wird.
Warum Branchendurchschnitte die eigene Zahl nicht ersetzen
Der schnellste Weg zu einer Zahl führt über einen veröffentlichten Report: durchschnittliche Kosten eines Datenlecks, Durchschnittswerte je Branche und Unternehmensgröße. Solche Werte haben ihren Platz als Größenordnung und als Argument, dass das Thema überhaupt relevant ist.
Als Entscheidungsgrundlage taugen sie wenig. Ein Durchschnitt beschreibt die Erfahrung anderer Unternehmen mit anderer Systemlandschaft, anderer Absicherung und anderem Geschäftsmodell. Er beantwortet die Frage „Was kostet so etwas üblicherweise?“, nicht die Frage „Was kostet es uns?“. Wer ein Budget gegen das Controlling verteidigt, wird genau nach diesem Unterschied gefragt.
Der Durchschnitt ist damit der häufigste Grenzfall der Unterscheidung zwischen gezählt und modelliert: Er sieht aus wie ein gezählter Wert, weil ihn jemand erhoben hat — für das eigene Unternehmen ist er trotzdem ein modellierter. Belastbar wird eine Quantifizierung erst, wenn die gezählten Anteile aus dem eigenen Haus stammen. Der modellierte Anteil bleibt bestehen; er wird nur ehrlich als solcher gekennzeichnet.
Wie die Rückfrage verläuft
Die beiden folgenden Gespräche sind erfundene Beispiele. Die Beträge stammen aus keinem tatsächlichen Fall.
Zuerst die Variante, die schiefgeht:
Geschäftsführung: „Woher kommen die 1,2 Millionen Euro?“
Sicherheitsverantwortliche: „Aus dem Modell.“
Damit endet das Gespräch, und zwar nicht zugunsten des Budgets. Nicht weil die Rechnung falsch wäre — sie kann völlig korrekt sein. Sondern weil auf der Folie eine Zahl steht, die sich nicht mehr zerlegen lässt.
Und nun dieselbe Vorlage, aber mit zwei getrennten Zeilen statt einer Zahl — beide auf dasselbe Jahr bezogen:
Geschäftsführung: „Auf der Folie stehen zwei Zeilen statt einer Zahl. Warum?“
Sicherheitsverantwortliche: „Weil es zwei verschiedene Größen sind. Die erste ist gezählt: 170.000 Euro pro Jahr, im Mittel der vergangenen zwei Jahre, aus vier dokumentierten Vorfällen — Aufwand, Ausfall, externe Unterstützung. Jede Position steht in der Datei, die das Controlling bekommt.“
Geschäftsführung: „Und die zweite Zeile?“
Sicherheitsverantwortliche: „360.000 Euro jährlich erwarteter Verlust für einen Produktionsstillstand, den wir noch nie hatten. Der Betrag ist modelliert und steht auf zwei Annahmen: Ein solcher Stillstand dauert länger als einen Tag und kostet uns rund 1,8 Millionen; und statistisch trifft er uns einmal in fünf Jahren. Ein Fünftel von 1,8 Millionen ist der Jahreswert.“
Geschäftsführung: „Dann ist die zweite Zahl geraten.“
Sicherheitsverantwortliche: „Geschätzt. Der Unterschied ist, dass ich Ihnen sagen kann, worauf die Schätzung beruht.“
Geschäftsführung: „Dann sagen Sie es. Warum einen Tag? Warum nicht vier Stunden oder drei Tage?“
Sicherheitsverantwortliche: „Weil die Fertigung sagt, dass der Wiederanlauf nach einem vollständigen Stillstand eine Schicht kostet, und weil wir bei der letzten Netzstörung sechs Stunden gebraucht haben — bei kleinerem Umfang. Ein Tag ist die vorsichtige Auslegung dieser beiden Punkte.“
Geschäftsführung: „Und wie stark hängt Ihre Zahl an genau dieser Annahme? Zeigen Sie mir vier Stunden und drei Tage.“
Sicherheitsverantwortliche: „Bei vier Stunden fällt der Jahreswert auf gut ein Drittel, bei drei Tagen steigt er auf das Zweieinhalbfache. Die Annahme ist damit der stärkste Hebel im ganzen Modell — deshalb steht sie oben und nicht in der Fußnote.“
Der Unterschied zwischen beiden Gesprächen liegt nicht in der Rechnung, sondern in der Zerlegbarkeit. Im ersten Fall endet die Rückfrage in einer Sackgasse. Im zweiten Fall wird sie zum Bestandteil der Vorlage — und die härteste Frage ist nicht die nach der Zahl, sondern die nach der Annahme dahinter. Wer diese Frage nicht beantworten kann, hat nicht quantifiziert, sondern geraten.
Drei Fragen, die eine Zahl aushalten muss
Daraus folgt ein einfacher Arbeitsmaßstab. Damit klar ist, woher er kommt: Er stammt aus Budgetgesprächen dieser Art. Er ist keine Norm, keine anerkannte Methodik und keine regulatorische Anforderung.
- Steht auf der Folie die Spanne oder ihr Mittelwert? Eine Spanne mit Konfidenzband ist ehrlicher und zugleich schwerer angreifbar als eine scheingenaue Einzelzahl.
- Ist jede modellierte Größe als modelliert erkennbar — und zwar dort, wo die Zahl steht, nicht in der Fußnote?
- Existiert zu jeder gezählten Zahl die Zeile, aus der sie stammt — und liegt diese Zeile bereit, statt erst zusammengesucht werden zu müssen?
Der stärkste Einwand dagegen
Dieser Einwand kommt selten von der IT und fast immer aus dem Finanzbereich: „Für eine Entscheidung über Versicherungsschutz, Rücklagen oder die Aufteilung des Gesamtbudgets brauche ich eine Zahl. Zwanzig Zeilen mit unterschiedlichen Konfidenzbändern kann ich einem Aufsichtsgremium nicht vorlegen.“
Der Einwand ist berechtigt, und er hebt die drei Fragen nicht auf — er wendet sie ein zweites Mal an. Mehrere modellierte Werte zu einer Summe zusammenzufassen ist zulässig; was nicht geht, ist die Verrechnung modellierter mit gezählten Werten. Denn nach der Regel von oben trägt das Ergebnis immer das Etikett seines schwächsten Bestandteils: Eine zusammengefasste Risikozahl bleibt modelliert, weil geschätzte Größen in sie eingehen. Sie darf deshalb nicht so geführt werden, als sei sie von derselben Art wie tatsächlich angefallene Kosten. Und die Zerlegung muss verfügbar bleiben, nicht bloß irgendwo existieren: Wer die Summe vorträgt, muss die Zeilen dahinter im selben Termin öffnen können. Wird beides eingehalten, ist gegen eine einzige zusammengefasste Zahl nichts einzuwenden.
Was Sie brauchen, um Ihr Cyber-Risiko zu quantifizieren
Für den gezählten Anteil brauchen Sie drei Dinge, und alle drei sind dort zu suchen, wo ohnehin Daten geführt werden:
- Ausgaben je Gerät und je Nutzer — aus Verträgen, Lizenzabrechnungen und Rechnungen.
- Dokumentierte Vorfälle mit tatsächlichem Aufwand — aus dem Ticketsystem, nicht aus der Erinnerung.
- Eine Zuordnung der Ausgaben zu Kategorien — damit erkennbar wird, wohin das Budget fließt.
Werden diese Daten schon geführt, beginnt die Arbeit bei der Auswertung. Fehlen sie, beginnt die Arbeit bei der Erhebung — das ist die unbequeme, aber ehrliche Antwort auf die Frage, warum eine Quantifizierung manchmal länger dauert als erwartet. Den Aufwand bestimmt dabei die Zahl der Ereignisklassen, die betrachtet werden sollen, und das ist eine Entscheidung, keine Frage der Mitarbeiterzahl.
Für den modellierten Anteil gibt es keine Datenquelle, weil das Ereignis noch nicht eingetreten ist. An ihre Stelle treten drei Wege, die sich ergänzen:
- Eine strukturierte Schätzung derjenigen im Haus, die den betroffenen Prozess kennen.
- Ein durchgesprochenes Szenario mit dem Fachbereich, das Dauer und Ausbreitung festlegt.
- Veröffentlichte Schadensdaten als Plausibilitätsanker — als Prüfung, ob die eigene Schätzung in einer sinnvollen Größenordnung liegt, nicht als Wert, den man übernimmt.
Entscheidend ist bei allen drei Wegen dasselbe: Die getroffene Annahme wird aufgeschrieben und bleibt änderbar. Und geschätzt wird nicht ein Wert, sondern drei — der günstigste Fall, der ungünstigste und der wahrscheinlichste. Aus diesen drei Werten entsteht die Bandbreite, die am Ende auf der Folie steht; die Eingangsgrößen werden dafür vielfach durchgerechnet, und das Ergebnis ist wieder eine Verteilung statt einer einzelnen Zahl.
Umsetzung im Financials-Modul von Mahoney Control
Genau entlang der drei Fragen ist das Financials-Modul von Mahoney Control gebaut.
Zur ersten Frage: Die Risiko-Engine quantifiziert nach dem FAIR-Modell — einer Analyse-Methodik, keiner Zertifizierung — und gibt das Ergebnis als Bandbreite mit Konfidenzband aus, nicht als Punktwert.
Zur zweiten Frage: Das Modul beginnt mit vier Kennzahlen in Euro: Kosten pro Gerät, Ausgaben pro Nutzer, Kosten pro Vorfall und der Risk Exposure Value — der modellierte Betrag, der das eigene Risiko in Euro ausdrückt. Die ersten drei werden aus Ihren echten Ausgaben- und Vorfallsdaten gezählt. Die vierte ist modelliert und als modelliert gekennzeichnet, direkt auf der Kachel und nicht in einer Fußnote. Beide Arten werden nie zu einer gemeinsamen Ergebniszahl addiert. Auch der ROI-Simulator legt seine Annahmen offen: Zwei Eingaben ergeben einen strukturierten Business Case samt Return on Security Investment (ROSI). Nach der Regel von oben ist der ROSI selbst ein modellierter Wert — in ihn geht eine geschätzte Risikoreduktion ein, also trägt das Ergebnis dieses Etikett, auch wenn die Ausgabenseite gezählt ist. Wird eine angezweifelt, ändert man sie, und der Business Case rechnet sich neu.
Zur dritten Frage: Ein CSV-Export übergibt dem Controlling die Rohdaten in dem Format, das es ohnehin verwendet — keine Bildschirmfotos, kein Abtippen. Geprüft wird die Zeile damit dort, wo das Controlling ohnehin arbeitet, und nicht in einem Dashboard, zu dem es erst Zugang braucht.
Mahoney Control mappt Kundenkontrollen gegen Rahmenwerke wie ISO 27001, NIS 2 und SOC 2 Type II. Dies stellt keine Zertifizierung von Mahoney IT gegen diese Rahmenwerke dar. Die Zertifizierung wird von unabhängigen Auditoren erteilt.
Zurück an den Tisch
Die Frage vom Anfang — „Und was kostet uns das jetzt?“ — ist beantwortbar. Aber nicht mit einer Zahl, die stimmt. Ob die Zahl stimmt, weiß niemand; sie beschreibt eine Zukunft, die noch nicht eingetreten ist.
Beantwortbar ist die Frage mit einer Zahl, deren Herkunft sich Zeile für Zeile zeigen lässt. Der gezählte Teil steht im Hauptbuch. Der modellierte Teil steht unter einer Annahme, der jemand widersprechen darf.
Das ist der ganze Unterschied zwischen einer Zahl, die ein Budget trägt, und einer, die eine Präsentation schmückt.
Wenn Sie sehen möchten, wie sich Ihre eigenen Zahlen in dieser Struktur abbilden lassen, sprechen Sie uns an.
Häufige Fragen zur Cyberrisiko-Quantifizierung
Woran erkenne ich, ob eine Risikozahl belastbar ist?
Aus der Sicht dessen, der die Zahl prüft, sind drei Dinge zu klären. Ist eine Spanne angegeben oder nur ein einzelner Wert? Lässt sich am Wert selbst ablesen, ob er gezählt oder modelliert wurde, ohne dass man dafür in die Fußnoten muss? Und lässt sich zu jedem gezählten Betrag die Quelle benennen, ohne dass jemand danach suchen muss? Diese drei Merkmale sind ein Arbeitsmaßstab aus Budgetgesprächen — keine Norm, keine anerkannte Methodik und keine regulatorische Anforderung.
Was bedeutet es, dass ein Wert modelliert ist?
Modelliert heißt: Der Wert wurde nicht gezählt, sondern aus Annahmen berechnet. Für Ereignisse, die im eigenen Haus noch nie eingetreten sind, gibt es keine eigene Erfahrungsbasis; die erwartete Häufigkeit und die Auswirkung müssen deshalb geschätzt werden. Das ist zulässig und üblich — entscheidend ist, dass die Annahme sichtbar bleibt und geändert werden kann. Ein modellierter Wert, der wie ein gezählter präsentiert wird, ist dagegen irreführend, auch wenn die Rechnung dahinter korrekt ist.
Welche Daten brauche ich, um mit der Cyberrisiko-Quantifizierung zu beginnen?
Eine Cyberrisiko-Quantifizierung besteht aus einem gezählten und einem modellierten Anteil. Für den gezählten Anteil sind drei Dinge nötig: Ausgaben je Gerät und je Nutzer aus Verträgen und Abrechnungen, dokumentierte Vorfälle mit dem tatsächlich angefallenen Aufwand aus dem Ticketsystem, sowie eine Zuordnung der Ausgaben zu Kategorien. Der modellierte Anteil beruht nicht auf Daten, sondern auf Annahmen, die offengelegt und veränderbar sein müssen. Werden die genannten Daten schon geführt, beginnt die Arbeit bei der Auswertung; werden sie es nicht, bei der Erhebung. Den Aufwand bestimmt dabei die Zahl der betrachteten Ereignisklassen, nicht die Zahl der Mitarbeiter.
Wie oft sollte die Cyberrisiko-Quantifizierung wiederholt werden?
Für die Quantifizierung selbst gibt es keinen allgemein vorgeschriebenen Turnus. Regelwerke, denen ein Unternehmen unterliegt, können eigene Vorgaben zur regelmäßigen Überprüfung des Risikomanagements enthalten; welche Vorgaben im Einzelfall gelten, ist rechtlich zu bewerten. Fachlich sinnvoll ist die Wiederholung immer dann, wenn sich eine der Eingangsgrößen ändert: nach einem Vorfall, nach einer größeren Änderung an der Systemlandschaft, bei der Budgetplanung oder wenn sich eine getroffene Annahme als falsch erwiesen hat. Eine Quantifizierung, die niemand mehr anfasst, altert schneller als die Systemlandschaft selbst.
Hinweis zu Rahmenwerken: Mahoney Control mappt Kundenkontrollen gegen Rahmenwerke wie ISO 27001, NIS 2 und SOC 2 Type II. Dies stellt keine Zertifizierung von Mahoney IT gegen diese Rahmenwerke dar. Die Zertifizierung wird von unabhängigen Auditoren erteilt. Die einzige förmliche Zertifizierung, die Mahoney IT selbst hält, ist ISO 9001:2015, erteilt durch DEKRA. Diese Zertifizierung gilt für Mahoney IT Group Germany.
Hinweis zu den dargestellten Werten: Die in diesem Beitrag beschriebenen Verfahren liefern modellierte Schätzungen. Diese Schätzungen ersetzen weder eine rechtliche noch eine versicherungsfachliche oder betriebswirtschaftliche Beratung im Einzelfall und treffen keine Aussage darüber, welche Beträge in einem konkreten Unternehmen tatsächlich anfallen.


